
LLM local vs API: precisión, coste y energía en un ensayo con seis modelos de lenguaje y 588 preguntas.
Encore Lab publica el 10 de noviembre de 2026 un benchmark que compara modelos de lenguaje ejecutados en local con modelos servidos por API. La conclusión principal del estudio, realizado en colaboración con la Universidad de La Rioja, centrado en la disyuntiva LLM local vs API, es clara: el mejor modelo local del ensayo, DeepSeek V4.1 Flash sobre dos NVIDIA DGX Spark, no muestra diferencias estadísticamente significativas de precisión frente a los mejores modelos por API. La decisión, por tanto, no va de qué modelo acierta más, sino de dónde se procesan los datos y de cuánto volumen de uso hay.
En este artículo
- Cómo se midió: 588 preguntas, seis modelos y tres benchmarks de referencia, con el consumo eléctrico registrado por BullSens.
- Coste real: electricidad, inversión y amortización de dos DGX Spark frente al pago por uso de la API.
- Qué elegir: recomendación según si los datos pueden enviarse a un proveedor de API y según el volumen de uso.
Cómo se diseñó el ensayo: 588 preguntas y seis modelos
El trabajo se apoya en 588 preguntas y seis modelos: tres ejecutados en local y tres accedidos por API. Firman el estudio Leon Arnedo y David Max (Encore Lab) junto a Ana González Marcos (Universidad de La Rioja).
| Ficha del ensayo | Detalle |
|---|---|
| Benchmarks de referencia | IFEval, LongBench y GPQA Diamond |
| Periodo de ejecución | Del 29 de octubre al 2 de noviembre de 2026 |
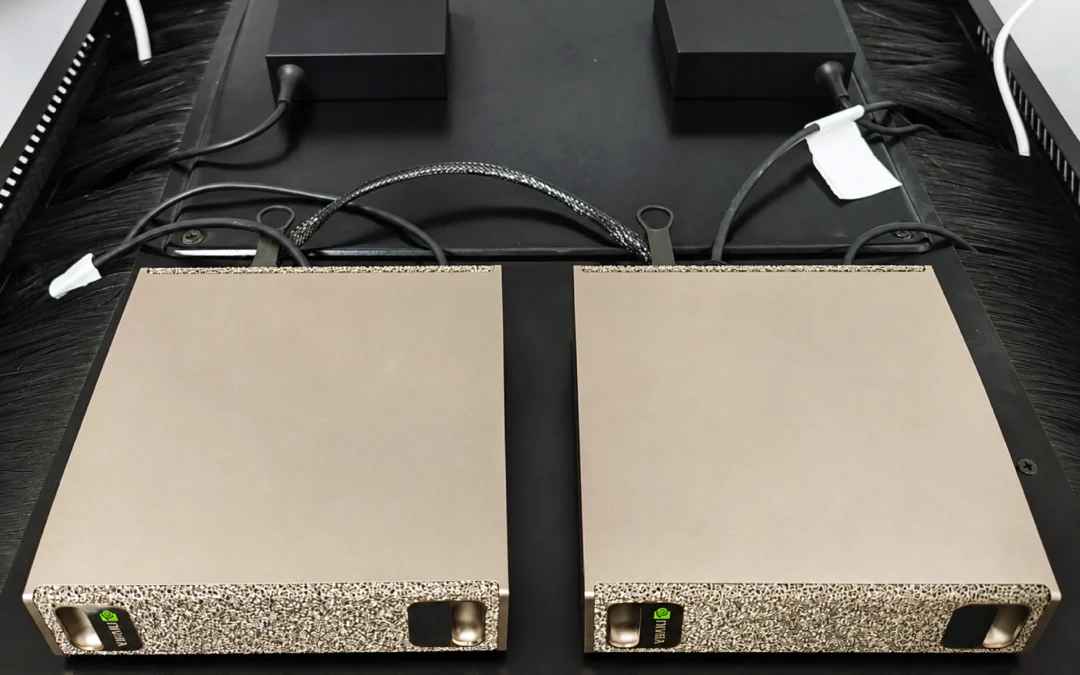
| Hardware local | Dos NVIDIA DGX Spark |
| Medición de energía | BullSens, con enchufe Milesight WS523 y gateway LoRaWAN UG63 |
El hardware: dos DGX Spark
Las pruebas se ejecutaron sobre dos DGX Spark. El conjunto sirve un modelo a la vez y aguantó horas por encima del 91 % de uso de GPU sin limitación por temperatura o potencia.
Memoria
128 GB
de memoria unificada en cada DGX Spark.
Interconexión
200 Gb/s
de enlace directo entre los dos equipos.
Carga sostenida
8 h 45 min
de ejecución continua con Qwen, por encima del 91 % de uso de GPU.
Resultados: LLM local vs API, precisión comparable
DeepSeek V4.1 Flash en local alcanzó 95,3 % en IFEval y 86,9 % en GPQA Diamond, con 26,8 s por pregunta y 1,71 Wh netos por pregunta: es el modelo local más rápido y el que menos energía neta gasta. Por API, Claude Opus 5.5 llegó al 90,9 % en GPQA y DeepSeek V4.1 Flash al 96,7 % en IFEval.
No hay diferencia significativa entre local y API, ni entre Opus y DeepSeek API.
Coste real: electricidad, inversión y amortización
Local · electricidad
0,35 €
por cada 1.000 preguntas con las dos Spark.
Local · inversión
10.742 €
sin IVA. Amortización orientativa de ~4 meses frente a Opus y de ~2,6 años frente a la API de DeepSeek en uso continuo.
API · Claude Opus 5.5
19,76 $
por ejecución completa (3,36 céntimos/pregunta).
API · DeepSeek V4.1 Flash
2,56 $
por ejecución completa (0,44 céntimos/pregunta).
En resumen
Opus 5.5 no fue significativamente más preciso y cuesta unas 8 veces más.
Cómo medimos la energía: BullSens y LoRaWAN
Los datos de consumo del informe no salen de una hoja de cálculo: BullSens, la plataforma IoT de Encore Lab para monitorización de espacios y edificios, recibió las lecturas del enchufe Milesight WS523 a través del gateway LoRaWAN UG63.
Con BullSens
Es un buen ejemplo de cómo IoT y analítica de datos se integran en el propio proceso de medición.
Recomendación según el caso de uso
- 1Si los datos no deben enviarse a un proveedor de API: DeepSeek V4.1 Flash en dos DGX Spark, instalado en la infraestructura del cliente o en equipos de Encore Lab con las condiciones acordadas.
- 2Si los datos pueden enviarse y el volumen de uso es moderado: la API de DeepSeek V4.1 Flash es la opción más barata, tras revisar las condiciones de tratamiento de datos.
- 3Opus 5.5 no aportó precisión significativamente mayor y multiplica el coste por ocho.
Límites que conviene tener en cuenta
- Una sola ejecución por modelo.
- Benchmarks en inglés: no miden rendimiento en castellano.
- Muestras parciales en LongBench e IFEval.
- No evalúa seguridad ni cumplimiento normativo.
¿Sabes cuánto consume tu edificio?
Si BullSens puede medir lo que gasta una IA, también puede hacerlo con tus instalaciones: consumo eléctrico y estado de tus espacios en tiempo real, con sensores LoRaWAN y una sola plataforma. Escríbenos a info@bullsens.com o solicita una demo y te ayudaremos a planificar tu primera instalación.
Sigue leyendo: Deja de pagar por la electricidad que no ves · Nuevo módulo Gateways: el control total de tu red LoRaWAN, en una sola pantalla


